功能
AI 虚拟博主生成器
作者:Ofrai Editorial(Use Case Research)
AI 虚拟博主生成器能造出一个合成创作者,让他在整条内容排期里长相、穿搭和视觉世界都保持可识别。你先确认一张母版图,之后每一张都拿它当参考,并且每次只改一个变量——服装、场地或机位。在 Ofrai,整个流程都在图片工作室里跑,用同一套积分,母版和每张定稿都存在素材库里随时可取。
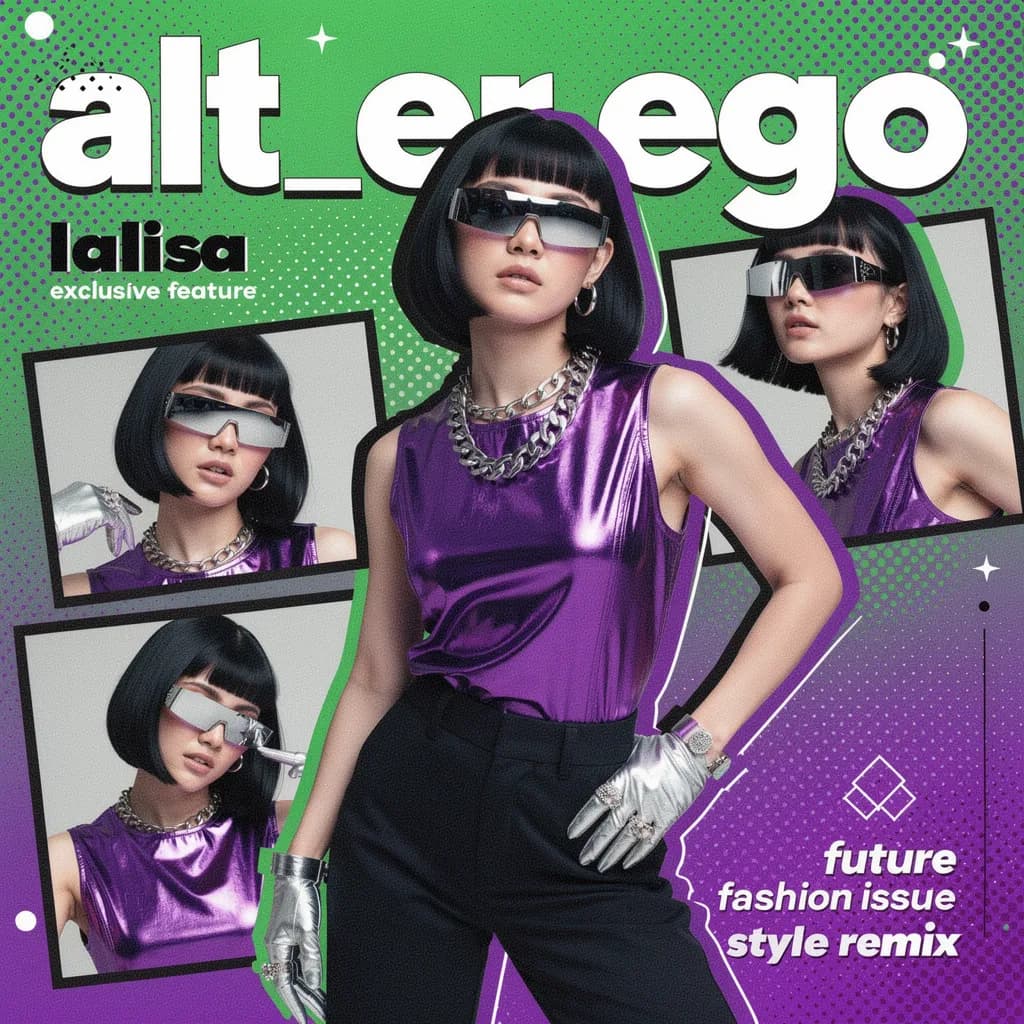
为什么观众会觉得「这是同一个人」
一致就是全部。观众在不到一秒内判断画面里是不是同一个人,靠的是骨骼结构、发型和肤色,而不是衣服。只用文字描述创作者必然漂移,因为每次生成都会采样出略微不同的脸。正确做法是列一份固定清单——脸型、发际线、眉间距,加一个辨识特征比如小痣——然后在每条提示词里逐字重复,再开始批量出图。
先做角色设定图,再做内容
第一张通过的图要当角色设定图,而不是当成品发布。先生成一张干净的中性帧:中性表情、均匀光线、纯色背景、半身构图。存下来,之后所有生成都以这个文件作为参考输入。接下来一次只改一个维度——服装、场地或机位——绝不同时改两个,因为同时改正是让系列失去同一感的元凶。
整个系列里这个参考文件不要动,重新导出或轻微修图都会改变条件信号,脸就会漂。
服装、场地与色调的成套规则
一致不等于每次都穿一样的。定好一组服装、一组场地和一条光线规则,剩下的交给模型变化姿态。服装要用面料和版型来写,而不是品牌名——「宽松米色针织配阔腿裤」比写品牌更稳,因为品牌词会引入不相关的参考。场地要守住同一套色调:今天暖米色、明天冷蓝色,哪怕脸完全一致,整体也会露馅。
系列内容里的参考图纪律
纪律决定了创作者是一次性玩票还是能长期用。全程只保留一张母版参考,绝不在一条提示词里混两种样子。需要第二套衣服或第二个场地时,从同一张母版重新生成,而不是在上一次的结果上改。如果内容需要双人或多家庭成员,分别单独生成,再在另一个图片任务里合成——把两张脸平均到同一帧,是创作者最容易「认不出」的原因。
按平台规划画幅,不要事后硬裁
按平台而不是按提示词来规划:Reels、TikTok、Shorts 用 9:16;带文案的信息流帖子用 4:5;轮播卡和电商列表用 1:1。直接按投放比例出图,裁切才不会切掉手臂或发际线。如果一张主视觉要兼顾多种比例,把人物放在画面中央并留足两侧空间,然后重新生成竖版,而不是裁横版原图——构图引擎给的竖版排版比后期裁剪更自然。
一致性崩了怎么救回来
常见三种:一是脸漂移,多半是混了参考图,或中途改了人物描述的措辞;修法是复制上一条通过的提示词,只改变量行。二是服装残留,新提到的服装类型和参考图里已有的款式撞了,要明确写出新单品并说明它替换什么。三是比例失真,宽镜头加小房间会让创作者像微缩模型,直接写清真实环境与房间大小。
创作者类需求该用哪个模型
默认用 nano-banana-pro:多张之间能稳住参考脸,长而具体的指令也基本不丢前面的约束。要印刷或大版面投放的主视觉,用 gpt-image-2,成本更高但更值得。flux-2 适合快速低成本地试服装和场地方案。seedream-5 适合偏插画的柔和风格,或画面里需要有可读文字的情况。建议 flux-2 试稿、nano-banana-pro 出片。
创作者成套图的可复用提示词模板
把下面这个骨架存进备忘录,每次生成时原样粘贴,只改中括号里的部分:「[名字],[年龄段],[脸型]脸,[发长与发质],[一个辨识特征]。身穿[用面料和版型描述的服装]。位于[场地],[光线描述]。[景别],[焦段],[画幅]。」其中不变量那一段永远不要改写措辞——换一种说法,等于告诉引擎你要一张不同的脸。一套图里只改服装行和场地行。
完整示例:「Ines,三十出头,椭圆脸,深色齐肩卷发,左颊一颗小痣。身穿宽松米色针织配阔腿裤。阳光下的水泥楼梯间,正午硬顶光。半身,85mm,4:5。」把针织换成铁锈色外搭衬衫、楼梯间换成自助洗衣房,第二张就出来了,其它一个字不用改。整套图共用同一张母版参考图,这是它读起来像同一个人的唯一原因。
锁住合成人脸的关键设置
分辨率对信息流内容的重要性常被高估,但对会被放大查看的图影响很大——小尺寸的人脸会掩盖掉大尺寸下才暴露的瑕疵。画幅要按投放平台设定,不要写死在提示词里。还有一条纪律:永远不要把修过图的母版重新上传当新参考,修饰会变成身份的一部分,未经修饰的母版反而会被读成另一个人。
看出一组图里的年龄、肤色与发际线漂移
有四种漂移特征会反复出现,成因各不相同。年龄漂移(相邻帧里看起来老了或年轻了五岁)几乎总是光线变了:硬侧光显老,平光显年轻,所以要固定光线那一行,而不是反复重写年龄。发际线漂移通常来自分镜变化,裁切更紧会让模型自行发明额头的范围。比例失真(人物像微缩模型或巨人)来自宽镜头加小房间。
有效的诊断习惯是:把新帧和母版以全尺寸并排放在一起,先看脸,再看剪影,其它都不看。
一个月十二条内容的生成成本
按一个批次规划一个月,而不是做十二次独立决策。典型的十二条内容——两张主视觉、六张场景或产品图、四张竖版——通常落在十二到二十次生成之间,因为大约三分之一的尝试会因为上述某一种漂移被丢弃。所有构图先用 flux-2 在最低可用分辨率上打草稿,这个阶段要找的失败是构图性的,分辨率并不会改变一个姿势是否成立。
通过的构图再用 nano-banana-pro 正式出图,gpt-image-2 只留给真正要上大尺寸的主视觉。最常见的成本错误是:把一个已被否掉的方向重生成十次,而不是重写提示词。帧不对的时候,通常是需求写错了,再多重采样也救不回来。
它和 AI 模特工具不是一回事
两者表面上重叠,意图上分岔。AI 模特工具是为了把某一件具体服装穿在可信的身体上展示,通常一次一个造型,任务是垂坠、版型和产品可读性。AI 虚拟博主的目的是建立一个可复现的身份——观众在整条内容排期、整个 feed、一组广告里都能认出同一个人,所以它的真实产出是跨时间的一致性,而不是一张好图。
这意味着预算和精力要花在完全不同的地方:模特类工作的投入在服装参考和一次准确出图上,虚拟博主的工作则投在母版图和「绝不改动它」的纪律上。需求是「一张准确的产品图」时,用模特工具、保持简单;需求是「十二帖里能被认出是同一个人」时,这才是本页要解决的问题。
还有一个常见误区:把母版图在本地存了多个副本,生成时随手用了其中一个。母版只应有一个权威版本,其余都只是备份,因为同一张脸之所以稳定,靠的是每一次都喂给模型完全相同的条件信号,哪怕只是重新导出一次,信号就已经变了。请把它固定下来。请固定下来。请把它固定下来。
常见问题
- AI 虚拟博主可以接商业合作吗?
- 使用权取决于具体模型的使用条款和你在 Ofrai 的套餐;只要商业内容里出现合成人物,通常也有披露要求。签合同前请先看该模型页的条款,并在账号简介里明确标注这是 AI 形象。很多品牌接受合成人做产品导向的内容,但会限制那些依赖真人亲身经历的表述。
- 怎么让虚拟博主的脸在不同帖子之间不变?
- 锁定一张母版图,整个系列里原样使用。每条提示词都重复同一段外形描述——脸型、发际线、眉形、一个辨识特征——并且每次只改一个维度。在一条提示词里混两张参考图是漂移最常见的原因,中途换一种措辞描述同样会漂。
- 必须先有真人模特或实拍吗?
- 不需要。Ofrai 上大多数虚拟创作者都是从一张生成图开始的:先生成一张中性参考肖像,存下来,把它当成后续所有内容的身份锚点。如果你确实想要某种特定风格,一张清晰的参考照片给模型的信息,远比一大段文字描述脸要有效。
- Ofrai 能让我的虚拟博主动起来吗?
- 可以。把定稿静图送进视频工作室,用图生视频引擎做短视频、口播台词或产品演示。建议从半身中景开始、保证胸像以上构图清晰,裁得太紧会让动作模型无处发挥。静图和视频共用同一套积分,一个创作者可以在一处从头做到尾。
- 一套上线内容要准备多少张图?
- 六到十张覆盖大多数投放:两张主视觉、三到四张场景或产品图,再加一到两张竖版给短视频。全部从同一张通过的母版图生成,整套才会内部一致;只重渲染那些真正要大尺寸投放的帧。把已经否掉的方向再生成十个变体,纯属浪费积分。