功能
AI 动漫视频生成器
作者:Ofrai Editorial(Use Case Research)
AI 动漫视频生成器把设定图或一段文字变成有动漫质感的动态:发丝被风吹起、定格姿势接上情绪节拍、夸张的速度线。可靠的做法是先锚定帧:先在 Ofrai 图片工作室把角色画成一张干净的静帧,再在视频工作室让这张帧动起来,线条粗细、眼睛画法和服装细节才能保住。动漫感靠剪辑而不是靠长镜头,所以按短镜头分批生成。
片头、过场与循环片段
三种格式基本覆盖需求。片头:英雄姿态、细节特写、远景各两三秒,快切配乐。过场:一个角色、一个动作、一个情绪节拍,通常四到六秒。循环:飘落的花瓣、霓虹呼吸这类单一环境动作,回到第一帧。提示词里直接写明格式——「动漫片头镜头,快速推近英雄角色」——比只写「动漫视频」给模型的信息多得多。
用设定图当锚定帧
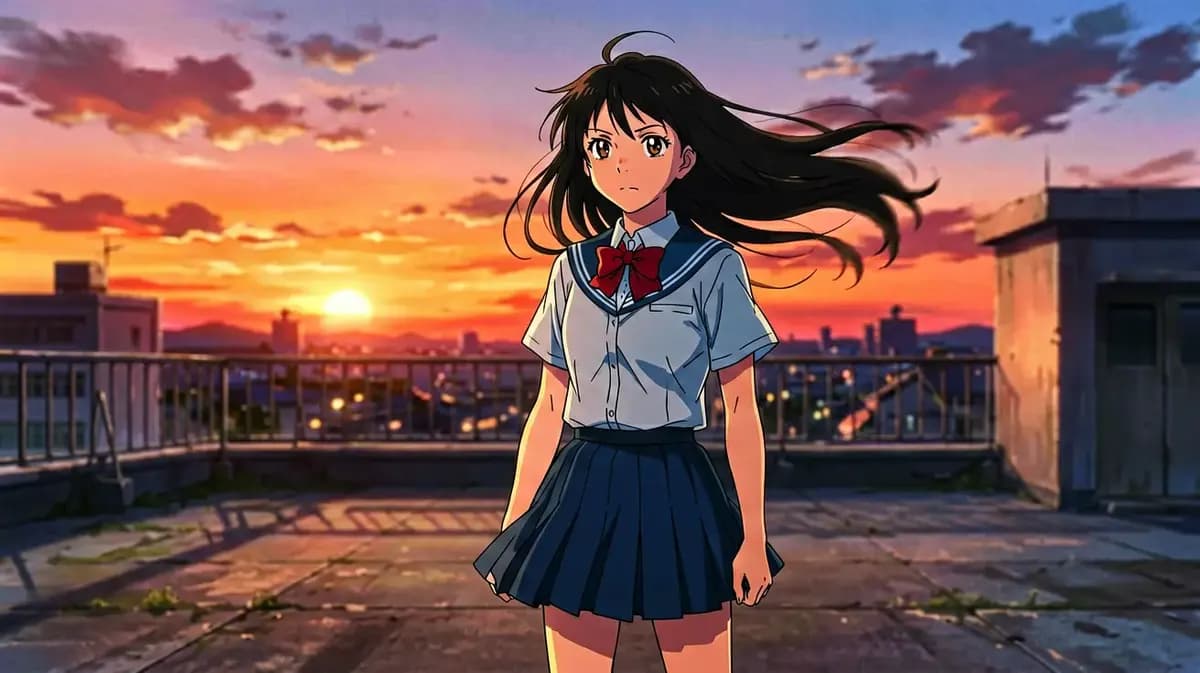
先把角色设计成静帧。干净的线稿、有表现力的大眼睛、平涂赛璐璐加一块硬阴影、背景简洁,这些在运动中最稳;柔焦厚涂则不行。把这张静帧作为图生视频起始图送进视频工作室,再用这个片段自己的语言描述运动。纯文生视频在第一秒就会丢掉线稿,因为它边做边发明设计。
模型吃得懂的镜头语言
动漫靠镜头词汇出彩,直接用术语:「眼睛极特写,瞳孔高光」「仰角英雄镜头,风吹头发」「中心放射速度线」「斜角构图,缓慢推近」「越肩镜头,角色转身」。一个镜头类型最多配一个动作。速度线 + 运镜 + 换装是最经典的翻车配方,出片通常连线稿质感一起丢掉。
哪个模型最能扛动漫动态
seedance-2-5 是性价比选择,也是设定图动画最稳的默认项:能在保持线稿的同时给出可读的运动。sora-2 场景运动更丰富、复杂运镜处理更好,预算充足时可用。gemini-omni 适合画面里必须同时出现文字或多个一致元素的片段。veo-3 物理真实感最强,适合电影感背景,但通常会把赛璐璐角色画得过于写实。
多镜头之间保持角色一致
一致性的做法是把同一组识别特征原样重复在每条提示词里:发型与发色、瞳色、服装件数与颜色、一件配饰。不要换措辞。然后整段序列固定同一个模型和同一个画幅。需要从特切到远景时,远景请从设定图重新生成,不要用特写片段做视频生视频,后者会大幅改风格。
色彩脚本与光线描述
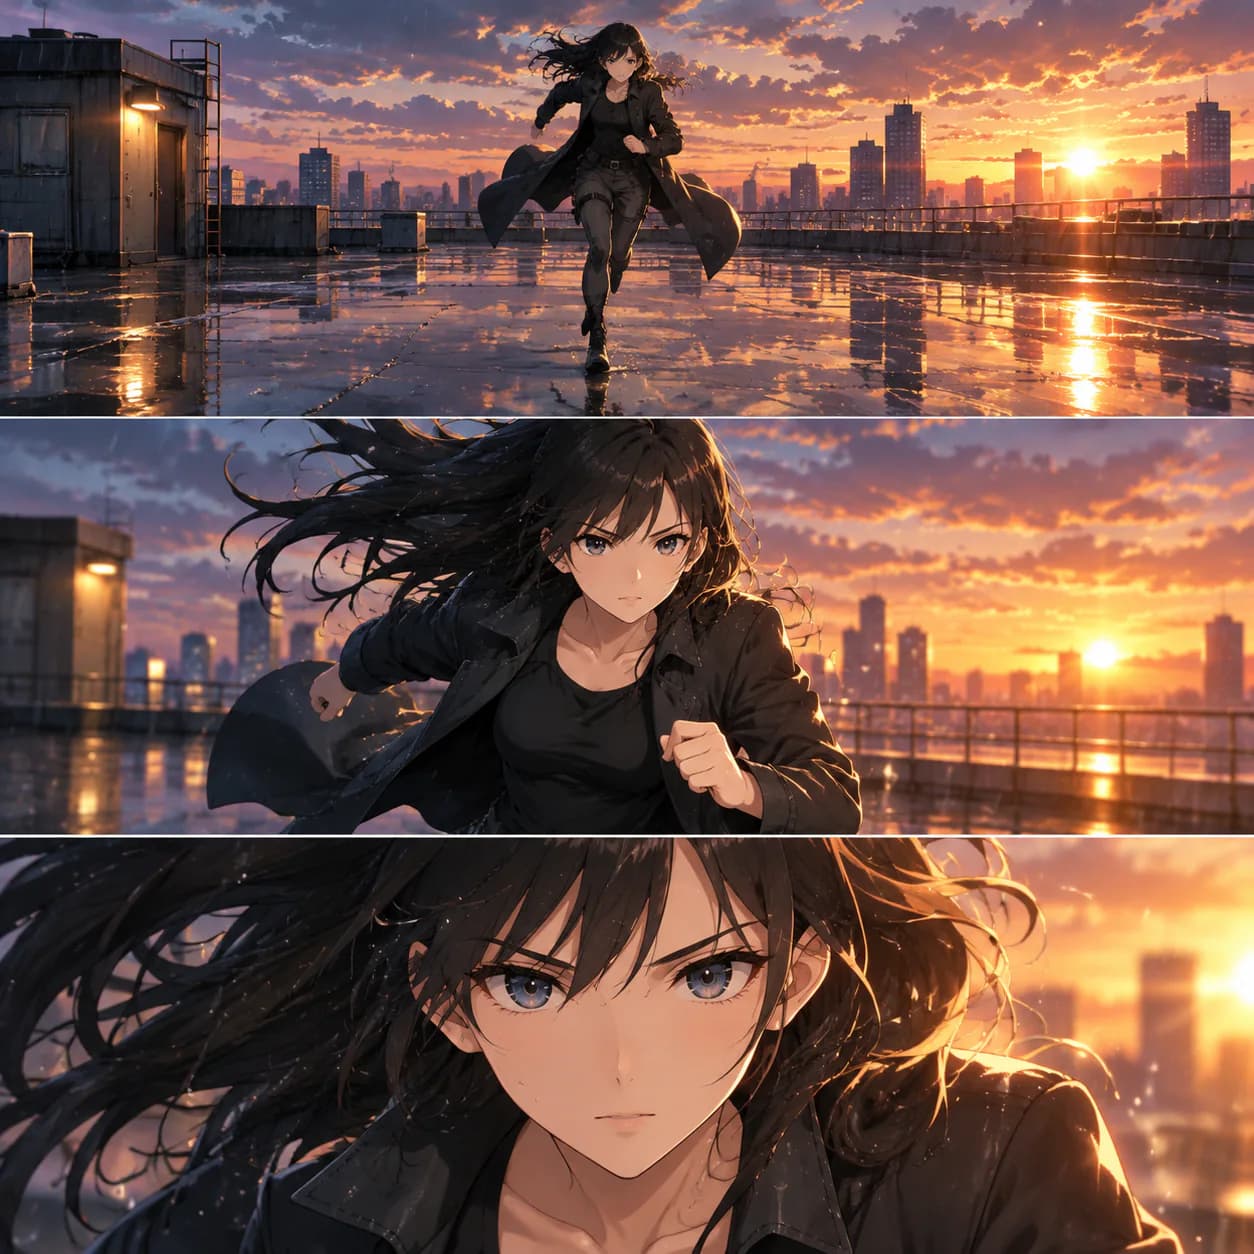
像动画导演那样写调色板和光源:「黄昏逆光,发丝橙色轮廓光,暗部偏冷蓝」「霓虹招牌在湿沥青上投下洋红与青色反光」「阴天平光,低饱和绿」。跨镜头的统一色彩脚本,是让一组生成片段看起来像同一部作品而不是四条视频的关键。少用「电影感」这种模糊词,否则每条片子会自己选色调。
修复融脸与风格漂移
风格漂移的表现是画面在两秒左右滑向真人感。对策是每一句都重复风格词,而不只是第一句,并把片段做短。融脸多来自转头和快速运镜,把转头换成眨眼加头发飘动更稳。如果连续三条都漂,说明锚定帧的动漫感不够,请回去重画静帧,而不是换模型。
三种动漫剪辑格式的可复制提示词
片头切:「动漫片头,低机位从下方快速推近主角,风吹动外套与头发,中心放射状速度线,两秒,硬边赛璐璐上色,无文字」。情绪过场:「单个人物黄昏站在屋顶,阴天光线,他低下头,握紧刀柄,慢速推近镜头,四秒,发丝金色轮廓光配城市冷蓝背景」。
环境循环:「夜晚雨中的安静街道,霓虹招牌映在湿沥青上,雨幕从画面左侧扫向右侧,花瓣被吹过,机位固定,片段回到首帧」。三条的骨架完全一致:先说格式,一个运镜,一个主体动作,然后时长。点明格式正是为了防止模型把每个请求都处理成缓慢的空镜。
三条都点明了时长,因为时长决定了这段素材在成片里承担的是冲击还是情绪。格式先行还有一个好处:同一句镜头描述放进不同格式里,模型会给出很不一样的节奏,所以先想清楚这段素材在成片里的位置,比先想画面细节更省返工。
写格式时把节奏也写进去,例如「三拍一剪」,模型对这种简单结构描述的响应比对抽象情绪描述更稳定。
片段时长与画幅
在视频工作室选择当前模型支持、且够用的最短时长。模型支持图生视频时,可上传已确认的参考图。固定画幅和角色描述,每次只调整一个动作。成片节奏和裁剪留到剪辑软件处理。
一整段动漫序列的积分预算
按镜头做预算。每次提交前核对当前模型和设置的预计积分。下载选中的片段,把提示词、模型、画幅和参考图另外保存在项目笔记里。
动漫片段和通用、写实视频的分工
当角色设计本身就是资产时用这一页:吉祥物、游戏或动漫 IP、同人企划,或者需要线稿对得上你手上已有主视觉的片头。通用视频工具更适合没有任何设计需要保护的实拍瞬间——房间里的产品、地点镜头、出镜讲话的人——因为它们优先保证运镜物理和照片真实感,而这恰恰是扁平赛璐璐上色的反面。
写实视频引擎很容易把赛璐璐角色拍得过实,一动就开始加皮肤毛孔和镜头炫光,风格瞬间崩掉。如果动漫只是一层覆盖在照片基底上的效果,而不是整张图的画风,改走照片动画路线更合适:源帧是真实画面,只加一点小动作。
需要对白口型的场景,这四个模型都做不好,所以动漫序列应当围绕停顿的眼神、动作和运镜来设计,台词留到后期再加。
风格总是漂移时,重做锚定帧
如果连续三条都往写实方向滑,问题在静帧而不在视频模型。锚定静帧的风格化程度不够,模型抓不住:检查它是不是用了绘画感渲染、柔和渐变或者照片级皮肤,然后重画成干净的线稿加平涂赛璐璐,保留一块硬阴影。角色要有大而有表现力的眼睛、简化的鼻子和嘴,以及平涂背景,这四样才是视频模型能跨帧带住的东西。
修好后在图片工作室里先把静帧当静帧看过一遍,通过了再送进视频工作室。这一步多花一张图,通常能省下四到五个视频重试。顺手把背景也简化:繁复的环境美术是风格漂移的第二大原因,因为运动一开始,模型要重新诠释的东西太多。静帧里保留一个明确的光线方向,片段提示词里重复同样的词,调色就不会在片段中途变掉。
背景越简单,运动中越不容易被重新诠释,所以安静背景常常比加更多细节更能救回风格。
示例
常见问题
- 做动漫视频前必须先画设定图吗?
- 不是必须,但这是最稳的路径。先在图片工作室把角色设计成静帧,视频工作室就能拿到锚定帧,线条粗细、眼睛画法和服装细节的保持度远好于让模型在生成过程中自行发明设计。
- 每个动漫片段做多长合适?
- 片头镜头两到四秒,过场节拍四到六秒。片段越长,模型越容易漂向真人实拍感,也越容易累积脸部变形,更长的序列应该由若干短片段剪出来。
- 哪个模型最能保住赛璐璐动漫风?
- 这一页里 seedance-2-5 最能保持锚定帧的线稿,积分成本也合理,是设定图动画的默认选择。veo-3 的物理真实感更强,但容易把赛璐璐角色画得太写实,通常不是动漫序列想要的。
- 怎么让同一个角色出现在多个镜头里?
- 在每条提示词里原样重复同一组识别特征——发型、瞳色、服装件数与颜色、一件配饰,不要换措辞。整段序列固定同一个模型和画幅,远景要从设定图重新生成,不要用特写片段做视频生视频。
- 为什么动漫视频一两秒后就变写实了?
- 这是风格漂移。请在提示词的每一句里重复动画风格,而不是只在第一句,并缩短片段、避免快速运镜。如果连续几条都这样,说明源设定的动漫感不够强,回去重画静帧。
- 动漫片段里可以加字幕或文字吗?
- 可以,这一页里 gemini-omni 更适合需要文字与主体同时保持一致的片段。文字要短,放在画面中稳定不动的区域,并多生成几条,因为字形最先失真。