功能
AI 真实感视频生成器
作者:Ofrai Editorial(Use Case Research)
AI 真实感视频生成器把一段写好的镜头描述变成看起来像拍出来、而不是画出来的画面:动作、景深和光线在几秒内都成立。在 Ofrai,你在视频工作室里写下分镜需求,选一个匹配镜头的模型,还能上传一张静态图作为片段的起始帧。
让 AI 真实感视频显得真实的到底是什么
观众判断真实感靠的是连续性,不是细节。单帧可以照片级真实,但如果背景物体在漂移、人物比例在帧与帧之间变化、光线方向中途偏了,片段就穿帮。写清哪些东西必须固定——机位高度、光线方向、画面内容——并在同一组镜头的每一条提示词里逐字保持一致。细节有加成,连续性才是说服力。
写出经得起运动的镜头描述
一句话、一个机位运动、一个主体动作。「缓慢推近厨房台面上的陶瓷马克杯,杯口冒热气,左侧清晨窗光,机位高度固定」是稳的;一段话里塞五个同时发生的动作则不是。描述镜头时用行为而不是数字更稳,例如「长焦压缩感」「广角带轻微桶形畸变」。结尾补一句不许变的东西:不要新增物体,不要翻转机位,不要形变。
用静态图作为首帧
需要连续性时就从图开始,因为片段会继承你已经认可的构图、服装和光线。先在图片工作室用 nano-banana-pro 或 gpt-image-2 生成主静帧,再把这张图上传到视频工作室,只描述接下来发生什么和镜头怎么动。这是做配对镜头最快的路径:同一套角色、产品和场景因此能被锁住。
四个视频模型分别适合什么镜头
画面要全屏观看、物理真实和自然光线最重要时用 veo-3,它是最保险的选择。需要电影感运镜和更长的连续镜头时用 sora-2。要快速迭代、同一条需求出多个变体,用 seedance-2-5。片段由参考图和复杂指令驱动、而不是单靠文字时,用 gemini-omni。
一眼暴露合成感的破绽
重点检查:皮肤或布料上的纹理游动、招牌文字逐帧变形、动作进行到一半手型变了、阴影和物体脱节。大部分问题靠缩短时长解决,因为错误会随帧累积。脸崩了就少生成几秒然后剪切,不要硬延长时间;背景漂移就点名画面里必须保持的物体,然后重新生成而不是修补。
时长、画幅与运镜语法
按最短可用长度规划片段,再在剪辑里组合起来:两段干净的三秒镜头好过一段不稳定的八秒镜头。画幅按投放平台选定并保持一致:网页和 YouTube 用 16:9,Shorts、Reels、TikTok 用 9:16,信息流用 1:1。运镜词汇要克制:固定机位、轻微漂移的手持、缓慢推轨、环绕、升降。一个片段里混两种运镜最容易让人眩晕。
哪些需求再真实的视频也救不了
不要要求画面里有清晰可读的文字、精确的品牌标识,或某一层架上确切数量的商品,这些是典型的失败场景,提示词再用力也救不回来。涉及真实可识别人物、且当事人未授权的需求,同样不要用。产品卖点如果依赖真实材质表现,就去实拍;氛围、情绪和 B-roll 用生成更快更便宜。
三种真实感完全不同、但都能落地的写法
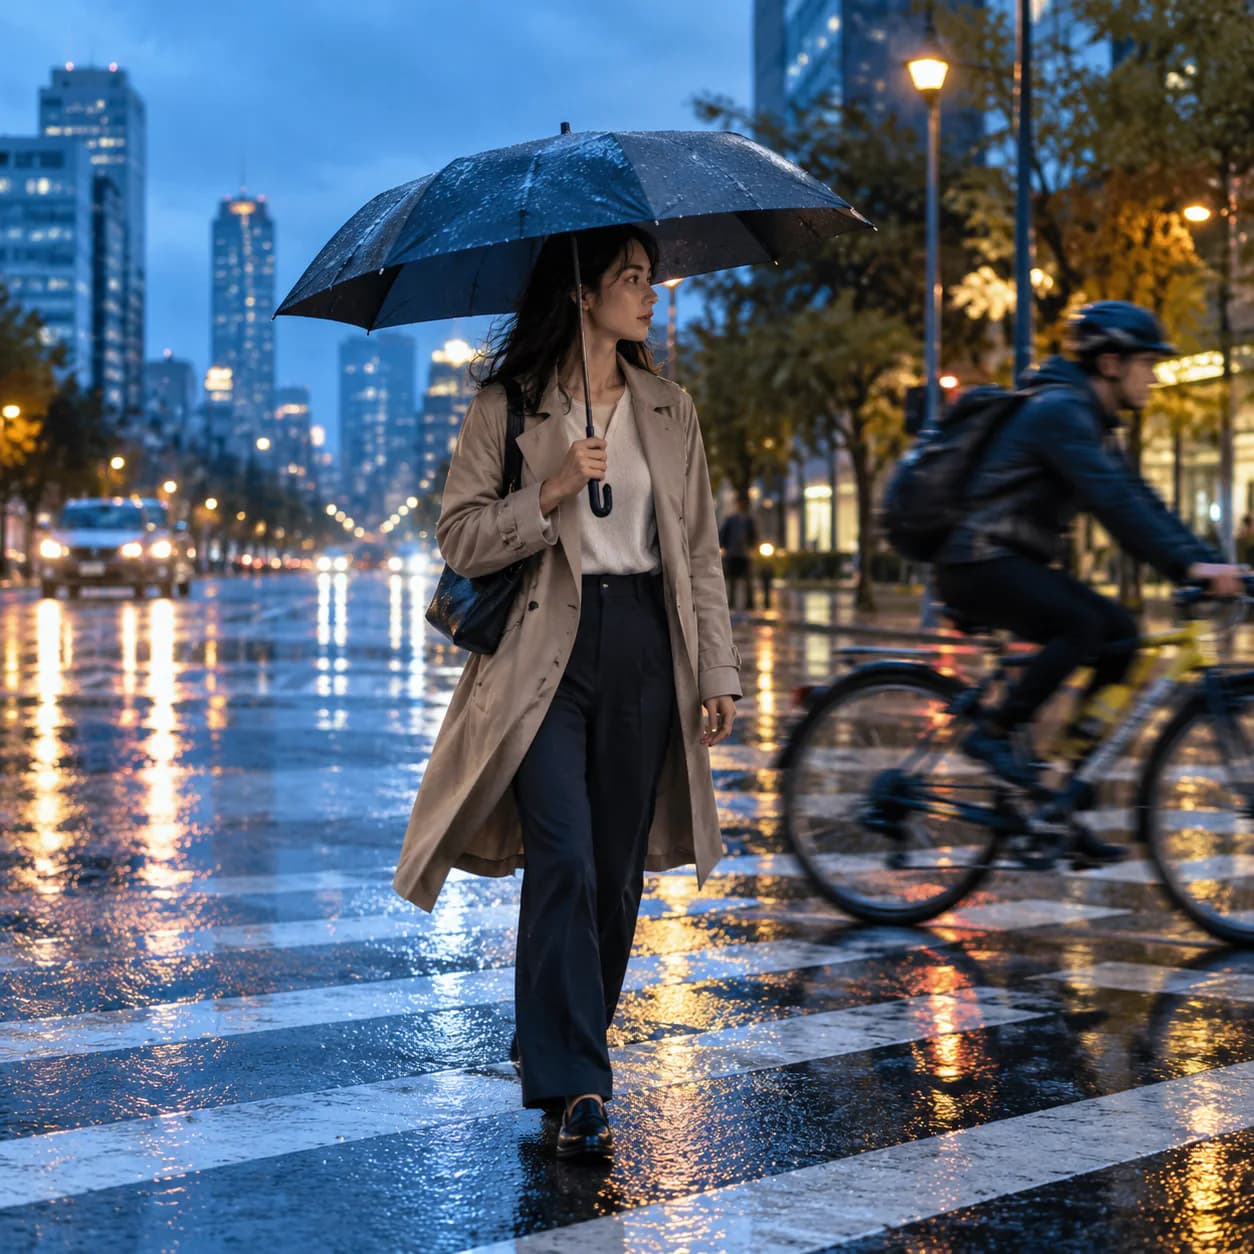
街拍纪实:「手持 35mm,下午晚些时候,一位穿绿色雨衣的女人走过积水的电车站台,画面有轻微的垂直漂移,阴天,色彩被压低,沥青上有环境反射,只有自然环境声,不要配乐。」厨房过程:「三脚架固定,50mm,两只手在撒了粉的橡木案板上揉面,左侧窗光,浅景深,空气里悬浮着面粉粉尘,实时连续动作,不要升格。」
产品运动:「不锈钢水壶在燃气灶上慢推,蒸汽升起,深色厨房,右侧一盏实用灯,拉丝钢面上的反光随镜头移动,全程平滑运镜,6 秒。」三条提示词都同时写清了机位、运动、光线,以及正在发生物理作用的材质。只写主体的提示词,等于把这四件事全都交给模型自由发挥,而被凭空发明的物理恰恰是真实感崩塌的地方。
时长、画幅与参考图
时长是最常被设错的选项。五到八秒是当前引擎能维持物理一致性的区间;超过十秒左右,手部、反射面和小物件开始漂移,正确的修法是拍两段、在剪辑时切换,而不是要求一次拍到底。画幅应该跟投放面一致——竖屏信息流 9:16、网站和 YouTube 16:9、正方形位 1:1——因为运动画面在剪辑软件里裁切,和直接按目标比例生成,结果并不相同。
只要场景有你想保住的具体样貌,就把参考图当首帧传进去。
声音比画面更快改变结论
观众对真实感的第一秒判断,很大程度上靠声音,而多数团队在剪辑之前完全没管音频。三层声音通常就足以把合成片段变成可信素材:符合室内环境的房间声、被操作物体上的轻微拟音、以及铺在所有声音下面的一层低频街道或室内底噪。
最先暴露的破绽是「该有声音的地方没有声音」——热闹的市场空无一人,咖啡馆里没有一点人声,这比任何画面瑕疵都更快被判定为假。如果你的流程里没有音频环节,就按「环境声之后会补」的意图去生成,并避开依赖可见说话动作的镜头。
口型同步失败的概率远高于「干脆不露嘴」,所以要么让说话者不出现在画面里,要么安排一个背对或侧对镜头的机位。
一条可信片段要花多少积分
真实感片段的成本高于风格化片段,几乎必然是因为你需要更多候选数和更长时长,而这两项会同时放大成本。
一条十秒可用镜头的实际预算是三到五次生成:先在一两个便宜的引擎上花一到两次定下构图和运镜,再用 seedance-2-5、sora-2 或 veo-3 出两到三次终稿,另外留一次作为备用,以防最后一秒翻车的那条。
每次生成前 Ofrai 都会显示这次消耗的积分;而在构图还没定下来时,用更低的分辨率和更短的时长做预览,能让探索阶段几乎不心疼。运镜没定之前不要出最终画质——提高分辨率只会让瑕疵更清楚,而不是把它们修掉。
什么时候该去租一台真摄影机
生成真正占优的地方是危险、昂贵、难以排期,或者同一个想法需要二十个变体:危险作业、极端天气、深空、历史场景、产品概念预演,以及之后要把演员合成进去的背景板。而当可信度本身就是产品时,就该租真摄影机:证词、纪录片、任何观众可能误以为真实发生过的画面,以及需要某个具体人物以可辨认的面貌、在多条镜头里保持一致表演的内容。
另外值得记住的是,大多数看起来不真实的素材,问题往往不在引擎,而在于缺了一张参考图、一个没有被约束的运镜,或者音频从头到尾就不在你的计划里。
AI 真实感视频和风格化、动漫片段生成的区别
真实片段生成是为物理可信度优化的,这也意味着它天然和风格化需求相冲突:夸张的配色、不自然的人体比例、漂浮的物体和不可能的运动,都会被它拉回纪录片式的行为。如果你要的是插画感、动漫风、低多边形或者重度调色,用风格化引擎会比用真实感引擎更听话,需要的返工次数也少得多。
真正有用的交集是一种顺序,而不是折中:先把基础画面当作可信素材生成,再在上面重新做风格。这样既保住了读起来真实的镜头行为,又把最终外观完全放开,这也是广告里需要真实空间感、再上色的标准做法。反过来,真实感引擎偶尔也能画出干净的插画风,但那需要你主动去对抗它的倾向,返工成本通常比一开始就用对引擎要高。
判断标准其实很简单:画面里有没有需要被观众相信的物理关系。有,就走真实感;没有,就放心风格化。
示例
常见问题
- Ofrai 上最真实的视频模型是哪个?
- 默认选 veo-3。它的光线、运动和物理表现能撑住几秒而不崩,是照片级真实最稳的选择;如果你更看重电影感运镜和更长的连续镜头,sora-2 同样出色。真实感也很大程度取决于需求本身:短、单运动的镜头在所有已上架模型上都很像真的。
- 怎么让同一个角色出现在多条片段里?
- 先为角色生成一张通过审核的静态图,再把这张图分别上传到每个片段,只描述动作和运镜。图生视频会继承画面里的构图、服装和光线,这比每次用文字重新描述角色可靠得多。
- 每个生成的片段应该多长?
- 剪辑允许多短就多短,通常三到五秒。时长越长质量越容易下降,因为错误会逐帧累积。正确做法是规划多条短镜头后在剪辑软件里拼接,并先把第一个镜头的运镜定下来,再去堆叠其他运动。
- 我可以把已经生成的图片做成视频吗?
- 可以。把图片上传到视频工作室作为起始帧,只写发生变化的部分:主体动作、镜头运动、蒸汽或布料这类环境动态。片段会继承图片的光线与构图,所以用一张精心做好的静态图去驱动,通常比一次性生成整个片段效果好。
- 为什么视频里的文字会变形或乱掉?
- 渲染文字是生成视频里最不可靠的环节,字母常常在帧与帧之间重排,或者直接糊成无法辨认的笔画,再怎么强调也基本无效。如果文字必须可读,就在片段里不生成文字,导出后在剪辑软件里合成字幕;或者干脆让文字不入画。
- Ofrai 的视频生成和图片用同一套积分吗?
- 是的。Ofrai 的文字、图片、视频共用一个积分余额,视频工作室在任务开始前会显示本次消耗。时长更长、分辨率更高消耗也更大,所以建议在低设置下试构图,锁定之后再渲染成片。