功能
AI 多人合影生成器
作者:Ofrai Editorial(Use Case Research)
AI 多人合影生成器必须解决两个让群像报废的问题:几张脸互相对不上,以及光线把人一个一个分开处理。在 Ofrai,你打开图片工作室,在 gpt-image-2、nano-banana-pro、flux-2、seedream-5 中选择,把整群人当成「一个被照亮的主体」来描述,而不是一份人员名单。三个朋友和十二人团队用同一套方法:设定唯一的主光方向,给每个人分配一个不同的轮廓,并且不要在提示词里塞入模型会渲染得不一致的个人细节。
多人出图为什么会崩,以及该怎么改
问题通常不是分辨率,而是注意力。扩散模型会把细节平摊到整张画面里,每多一张脸就分到更少一份。三人很轻松,五人可行,超过八人就要预期有一两张脸在年龄或骨相上漂移。办法是压低人数、拉宽到 3:2 这类画幅,并接受后排只作为氛围存在。
如果你确实需要大场面,先生成一张广角全景再裁切局部,而不是指望一次生成就给出十二张清晰的脸。
只描述一个光源
把光线写成一个真实的物理事件:「傍晚阳光从镜头左后方来,白墙提供柔和补光,所有人朝同一方向」。不要给每个人分别写光线,也不要叠加互相竞争的光源,比如「边缘光加霓虹加烛光」,模型会把它们分别分配给不同的人。统一的光线才让整组读起来像一张照片。如果出图像贴图拼贴,改法几乎从来不是加细节,而是删掉多余的光线描述,直到只剩一个。
给每个人一个不同的轮廓
脸之所以混乱,是因为引擎缺少区分它们的依据。给每个人一个清晰的形状:穿长外套的高个子、戴毛线帽和圆框眼镜的那个、胸前端着咖啡杯的那个。变化应该来自身高、站姿和道具,而不是五官细节,因为道具和姿态在整组里更容易保持稳定。构图上用松散三角形:前面两个、后面三个、一个在边缘站侧;等距排成一行会读成合影列队,而不是照片。
把团队肖像拍得像真的
真实的合照边缘总是不完美的:有人半侧身、有人在肩膀处被裁掉、有人离镜头近半步。把这种不完美写出来。「平视拍摄,35mm,轻微倾斜,右侧那位笑到一半被裁掉一半」比端正对称的站姿可信得多。最高的人头顶要留出空间,也别正好在额头高度裁断。
另一种选择是棚拍:无缝背景加正面均匀光,这对引擎来说比复杂环境容易得多。
人数不同该选哪个模型
脸部必须站得住时选 gpt-image-2,尤其是三到五人的紧凑站位,它给每张脸分到的注意力最多。nano-banana-pro 对「人数较多、服装各异」的长描述服从度更好。flux-2 快而便宜,适合先把站位打出来再精修。seedream-5 擅长大环境和背景人群。实用流程是:flux-2 排布局,gpt-image-2 出终版保证脸。
真正会遇到的失败与修法
三招能覆盖大部分翻车。脸粘连或重影,通常是人群太挤,在提示词里加一句「人与人之间留出间隔」或换成更宽的画幅。同一张图里肤色不统一,多半是光线描述互相冲突,删到只剩一个光源。肢体在被人遮挡处突然结束,最好的解法是重新写清楚谁在谁前面。
用完全相同的提示词重新生成不会有帮助,因为同样的歧义只会产生同样的歧义。
这个页面适合什么,不适合什么
这套流程适合概念图、团队横幅、节日贺卡、有虚构参与者的活动回顾,以及需要低成本得到一群一致角色的分镜。它不能替代真实相机——当画面里是真实、可识别的面孔时,生成输出达不到真实的相似度,也承担不起真实的肖像预期。请把这里的每一个人都当作虚构角色来描述,而不是某个具体的真名。
三条能撑住不崩的群像提示词
三个朋友户外:「三人在傍晚的小路上,夕阳从镜头左后方来,高个子穿墨绿色长外套,一个戴毛线帽和圆框眼镜,一个胸前端着咖啡杯,松散三角站位,平视 35mm,前排两人、后排一人错开半步,浅景深。」
五人团队:「五位同事穿各异的休闲商务装,站在清水混凝土墙前,右侧大窗的柔和均匀日光,肩膀放松,其中一人笑到一半、肩膀被裁掉一部分,最高的人头顶留出空间,3:2。」十二人以上的宽幅群像:「约十二人在楼梯平台上的合影,排成三排松散队列,后排略微柔化,暖色顶光,21mm 广角,保留较多环境信息。」
注意这三条共同缺席的部分:没有写年龄、发型和每个人的表情。这些正是引擎渲染最不一致的细节,刻意留白,整张图才立得住。
按人数决定画幅和纵深站位
按人数配比例,不要拿一个比例碰运气。三人用 4:5 就很宽裕;四到六人用 3:2,用横向空间换脸不必缩小;七到八人用 16:9 或 3:2,并把后排往后放一到两步,让引擎可以按自己的方式把后排处理得更柔。超过八人就渲染 16:9,把它当成之后要裁切的全景。
纵深同样要写明:「两排站位,第二排站在后方台阶上」,这比逐个列出谁在谁的左边有效得多——模型对「谁在后」的理解远比对「第三个站在中间偏右」的理解好。
让群像稳定的设置项
太低,脸会漂向千篇一律的长相;太高,画面会被过度「煮熟」,手部伪影反而被放大。从模型默认值起步,一批之内最多调一次。批量大小:一次四张,因为一旦两张脸粘连,同一批通常都有同样的毛病,浪费四张远比浪费十二张便宜。参考图:挂一张已认可的群像帧,把服装和光线一并带下去,这比挂任何单张人脸都有用。
画幅和镜头整轮保持固定,理由相同。
一张群像照要花多少次生成和多少积分
仍然按阶段花。先排布局:用 flux-2 在 3:2 上出四张便宜的图,你买的是站位而不是脸。再把最好的站位交给 gpt-image-2 出四张,脸好不好看就在这一步定下来。留下一张入选帧,基于它做变体(换裁切、换背景),不必重跑布局阶段。三人成片大约十到十二次生成;十二人宽幅图接近二十次,因为需要更多次才能清掉穿帮。
在 Ofrai,整组消耗都出自同一份积分余额,因此在布局模型和终版模型之间来回切换,付出的是生成次数而不是换套餐。预算固定时,宁可少做几种人数配置,也不要在同一种人数上反复重试——后者才是积分黑洞。
还有一个常被忽略的成本项:大批量生成会占满结果列表,让筛选本身变慢——每轮只保留两到三个候选,并把淘汰理由记下来,下一轮就能直接排除同类方案。
缩小之后才暴露的毛病
群像可以全尺寸无懈可击,放进九宫格却完全不能用。四道检查能抓到它。数还认得出的脸:把画面缩到很小,数一数还能辨认出几个人;如果少于你安排的人数,多出来的人就是噪声,应当往后挪或者干脆删掉。查光线梯度:只有一个方向、平滑衰减,不能有谁比阳光能解释的更亮。
查裁切边缘:正好在下巴处切断的头、在袖口接缝处断掉的肩膀,看起来都像意外事故。查重复:一张图里出现两张几乎一样的脸,是批量开过大的典型特征。
它和友情合影、团队横幅流程的区别
友情合影生成器优化的是两三个人和亲近感——肩膀相叠、视线交汇、暖调随性光,并且可以把大部分注意力放在两张脸上。团队横幅流程优化的是 Logo 留白、整齐的一排,以及足够容纳文字的空位。这一页覆盖的是中间地带:三到八人、可信的站位、以及一个能解释光线的真实环境。
团队肖像、活动回顾、分镜人群和概念图来这里;两人或三人的亲密合影去友情页;当构图必须为排版服务时,走横幅流程。
示例
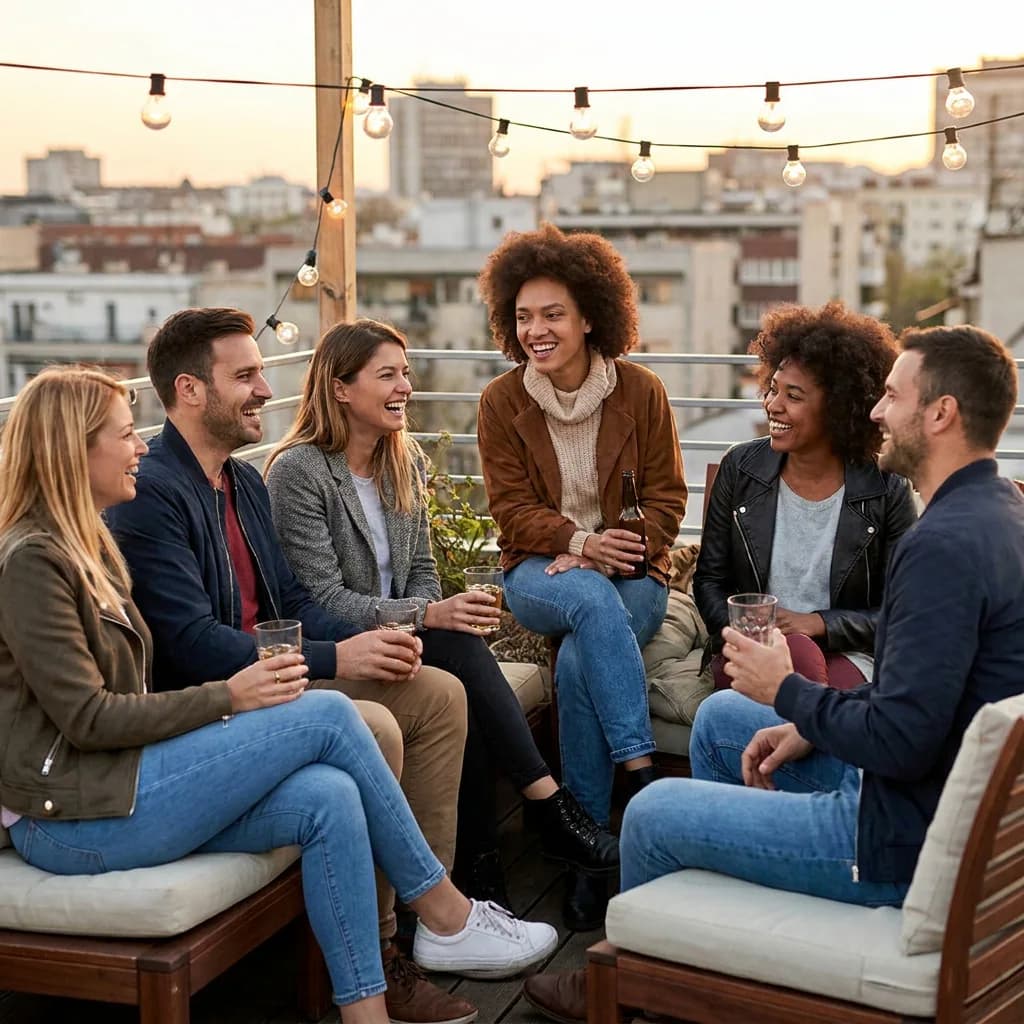
常见问题
- 一次能可靠地生成多少人的合影?
- 三到五人是最舒服的区间,到八人通常也可以,前提是后排保持柔和。超过这个数量就容易出现年龄或骨相漂移。人数更多时,先生成一张广角全景再裁切局部,而不是指望一次渲染出十二张清晰的脸。
- 怎么让整组人的光线保持统一?
- 只描述一个真实光源,并把它作为整体应用到全组,例如「傍晚阳光从镜头左后方来,所有人朝同一方向」。逐人写光线,或叠加边缘光、霓虹、烛光等多种光源,正是群像看起来像拼接的原因。
- 为什么同一张图里几张脸的画风不一致?
- 通常是因为几个人写得太像,引擎缺少区分他们的依据。改用轮廓来区分:身高、站姿、道具,比如毛线帽或咖啡杯;站位也用松散三角而不是等距排开,差异会更明显。
- 哪个模型在群像里的人脸最好?
- gpt-image-2 给每张脸分配的注意力最多,三到五人的紧凑站位表现最佳。nano-banana-pro 对人数多、服装变化大的长描述服从度更好,flux-2 则适合先低成本敲定布局再精修。
- 这些图可以当真实的家庭或团队照片用吗?
- 不可靠,也不合适。生成式输出无法按真实照片的标准复现真人的相貌,也缺少真人肖像所隐含的同意前提。这套流程用于虚构群像、概念图、横幅和分镜;涉及真人时请使用真实相机。
- 怎么避免人物被裁掉或挤在一起?
- 在提示词里要求人物之间留出空隙,或改用 3:2 这类更宽的画幅。脸粘连几乎都是因为人群过密。另外要重新写清楚谁站在谁前面,深度顺序含糊是肢体出错的一个常见原因。